Predicción de goles en el fútbol casi en tiempo real mediante visión artificial
Martes 15 de Diciembre 2020 / 14:23
⏱ 8 min de lectura
(Estados Unidos).- En un partido de fútbol, los fanáticos se emocionan al ver a un jugador correr por la línea lateral durante un contraataque o cuando un equipo está controlando el balón en el área de 18 yardas porque esas acciones pueden llevar a goles. Sin embargo, es difícil para los ojos humanos capturar completamente movimientos tan rápidos, y mucho menos predecir objetivos. Con el aprendizaje automático (ML), podemos incorporar información más detallada a nivel de píxel para desarrollar una solución que prediga los objetivos con mucha confianza antes de que sucedan.
Sportradar, un proveedor líder de datos deportivos en tiempo real que recopila y analiza datos deportivos, y el Laboratorio de soluciones de Amazon ML colaboraron para desarrollar un Predictor de goles de fútbol basado en visión por computadora para detectar momentos emocionantes que conducen a goles, lo que aumenta la participación de los fanáticos y ayuda a las emisoras a proporcionar a los espectadores una experiencia mejorada. La mayoría de los modelos de reconocimiento de acciones se utilizan para identificar eventos cuando ocurren, pero Amazon ML Solutions Lab desarrolló un novedoso Predictor de goles de fútbol basado en visión por computadora que puede predecir goles de fútbol futuros 2 segundos antes del evento.
"Lanzamos deliberadamente uno de los problemas de visión por computadora más difíciles posibles al equipo de Amazon ML Solutions Lab para ver qué podía hacer el arte de lo posible, y estoy muy impresionado con los resultados", dice Ben Burdsall, CTO del grupo en Sportradar. “El equipo construyó un modelo de reconocimiento de acciones de video para predecir los goles de fútbol futuros con dos segundos de anticipación utilizando Amazon SageMaker y demostró su aplicación para el seguimiento de la intensidad de los partidos. Esto ha abierto las puertas a muchas nuevas oportunidades comerciales. Los costos de implementación y la latencia de este modelo en nuestra línea de producción utilizando la infraestructura de AWS también parecen muy alentadores. Después de hoy, no tengo más escepticismo sobre el potencial de la visión por computadora para innovar nuestro negocio".
El equipo usó instancias de notebook de Amazon SageMaker para crear una canalización de procesamiento de datos que extrajo ejemplos de capacitación de videos sin procesar y usó el aprendizaje por transferencia para ajustar un modelo de Redes 3D Infladas (I3D). Los resultados han inspirado a los equipos de ciencia de datos e innovación de Sportradar a desarrollar nuevas estadísticas para incorporarlas en sus videos de transmisión para mejorar la participación de los fanáticos.
Esta publicación explica cómo aplicamos el aprendizaje por transferencia utilizando un modelo I3D hacia la predicción de objetivos y usamos la inferencia para crear un índice de intensidad para cuantificar la probabilidad de que un equipo anote goles. Además, discutimos cómo construimos un índice de impulso para medir el cambio de velocidad durante los ataques. (Ataque es un término de fútbol utilizado para describir el movimiento del equipo en posesión de la pelota). Con el índice de intensidad y el índice de impulso, podemos detectar si hay un momento intenso (un momento que conduce a un gol) en cerca en tiempo real mediante transmisiones en vivo y creación de productos para ayudar a los locutores a atraer a los fanáticos durante las transmisiones.
Procesando los datos y construyendo el modelo
Para capturar estos momentos intensos, traducimos este objetivo en un problema de clasificación binaria: diferenciar las actividades que conducen a metas de las que no. Las muestras de la clase positiva (clase de goles) son videoclips que están a 2 segundos de los goles, y los de la clase negativa son videos en los que los jugadores realizan actividades que no conducen a goles (clase de seguridad con balón). Generamos 1.550 clips de 398 partidos de fútbol profesional proporcionados por Sportradar.
Mucha acción puede suceder en unos pocos segundos durante los partidos de fútbol, por lo que usamos videos cortos para entrenar al modelo. Para este caso de uso, extrajimos clips de 5 segundos. Un desafío con el procesamiento de video es que leer múltiples transmisiones de video y extraer clips secuencialmente puede llevar mucho tiempo y tomar varias horas en completarse. Para acelerar el proceso de extracción de clips, creamos una canalización de datos utilizando multiprocesamiento en una computadora portátil de Amazon SageMaker usando una instancia ml.c5.18xlarge con 72 CPU para paralelizar el proceso de extracción de clips con mucha E / S y reducir el tiempo de extracción de clips de 12 horas a menos de 15 minutos.
Después del procesamiento de datos, creamos un modelo de clasificación binaria utilizando el modelo I3D del modelo zoológico de GluonCV. El modelo I3D utiliza convoluciones 3D para aprender información espacio-temporal directamente de los videos. Dado que no teníamos un gran conjunto de datos, empleamos el aprendizaje por transferencia y ajustamos el modelo I3D para obtener modelos de video de buen rendimiento con nuestros propios datos. Para obtener más información sobre el ajuste fino y un modelo I3D con GluonCV, consulte Ajuste fino de los modelos de video SOTA en su propio conjunto de datos.
Utilizando instancias de notebook de Amazon SageMaker, primero cargamos una red I3D previamente entrenada en el conjunto de datos Kinetcis400 en una notebook Jupyter. Luego, ajustamos esta red en los datos de Sportradar para encontrar el mejor conjunto de parámetros, especialmente aquellos específicos para los modelos de reconocimiento de acciones (por ejemplo, número de cuadros, número de segmentos, paso para muestreo de cuadros).
Resultados
We used as our primary metric for model evaluation because we wanted to capture near-100% goals (positive class). The following graphs depict the confusion matrix and the precision-recall curve. It can be seen that it is difficult for the model to differentiate between the two classes when we have near-100% recall. We re-calibrated the predicted probabilities to look at the model performance for achieving 80% and 90% recall for the positive class (sequence leads to a goal) respectively.
Usamos el recall como nuestra métrica principal para la evaluación del modelo porque queríamos capturar objetivos cercanos al 100% (clase positiva). Los siguientes gráficos representan la matriz de confusión y la curva de recuperación de precisión. Puede verse que es difícil para el modelo diferenciar entre las dos clases cuando tenemos un recuerdo cercano al 100%. Recalibramos las probabilidades pronosticadas para observar el rendimiento del modelo para lograr un recuerdo del 80% y el 90% para la clase positiva (la secuencia conduce a una meta) respectivamente.
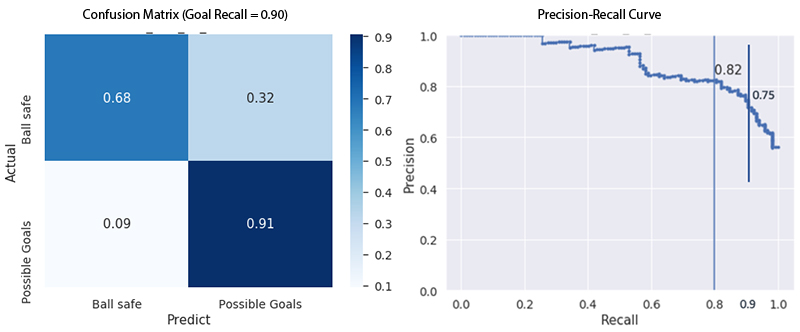
La siguiente tabla muestra la precisión y recuperación de la clase negativa cuando arreglamos la recuperación de la clase positiva. Podemos ver que nuestro modelo puede diferenciar las dos clases con la nueva configuración. Cuando fijamos la recuperación de la clase positiva en el 90%, podemos capturar el 68% de las muestras de la clase negativa y la precisión es del 75%.
Intensity index and momentum index
After training and validation, we selected the model that gives the best recall on the validation set. We generated inferences over three full games of video using a moving window with the predicted probabilities acting as the intensity index. To measure the change of velocity during attacks, we also generated a momentum index for the current timestamp, using the slope of the linear regression line of predicted probabilities from four previous timestamps. Finally, we used min-max normalization to scale the index between -1 and 1. Therefore, the momentum index effectively measures how the predicted goal probabilities change in the recent few seconds.
Índice de intensidad e índice de impulso
Después del entrenamiento y la validación, seleccionamos el modelo que ofrece la mejor recuperación en el conjunto de validación. Generamos inferencias sobre tres juegos completos de video usando una ventana móvil con las probabilidades predichas actuando como índice de intensidad. Para medir el cambio de velocidad durante los ataques, también generamos un índice de impulso para la marca de tiempo actual, utilizando la pendiente de la línea de regresión lineal de las probabilidades predichas de cuatro marcas de tiempo anteriores. Finalmente, usamos la normalización mínima-máxima para escalar el índice entre -1 y 1. Por lo tanto, el índice de impulso mide efectivamente cómo cambian las probabilidades de gol predichas en los últimos segundos.
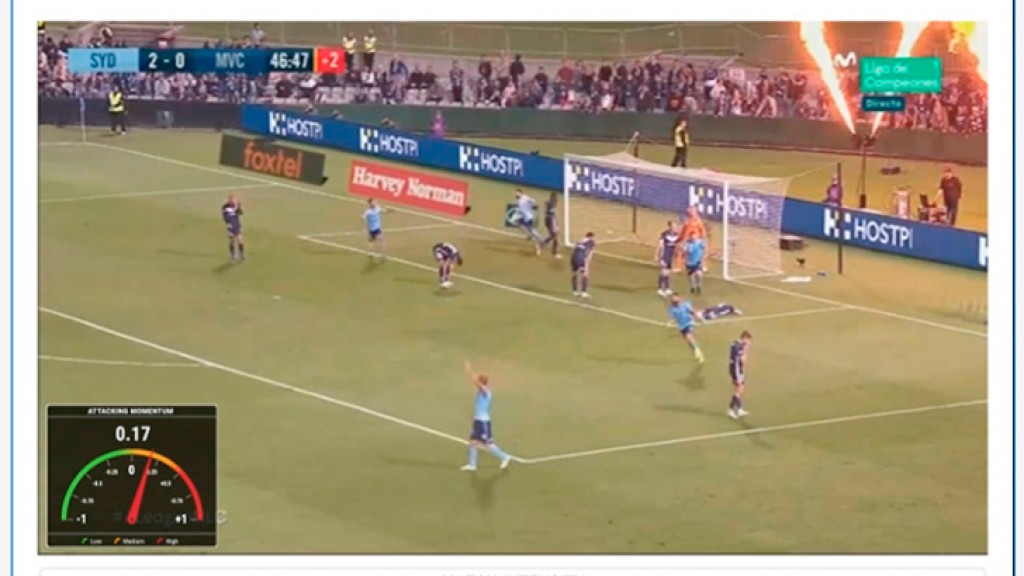
La siguiente imagen ilustra la inferencia del modelo usando una ventana móvil de 5 segundos en un clip de 40 segundos. Las áreas que están marcadas en rojo son momentos en los que los puntajes previstos señalan momentos intensos. Las dos primeras barras rojas representan una situación cercana al gol, un momento muy intenso en el juego. Finalmente, el equipo anotó un gol al final de ese clip durante la tercera barra roja de alta intensidad.
El medidor en el lado izquierdo mide el índice de impulso de -1 a 1, y el gráfico de líneas de intensidad del partido en la parte inferior son las predicciones de goles usando nuestro modelo. Debido a que puede suceder mucha acción en 2 segundos, las predicciones de alta probabilidad de gol del modelo siguen siendo razonables antes de que se pierdan los tiros.
Rendimiento del modelo en producción
Sportradar está invirtiendo en visión por computadora tanto a través de investigación interna, desarrollo y asociaciones externas. Para facilitar la transición rápida de los modelos de visión por computadora desde el laboratorio a la producción y la ejecución de modelos de visión por computadora a escala, Sportradar ha desarrollado una canalización de inferencia de visión por computadora en tiempo casi real utilizando los servicios de AWS. La canalización ayuda a garantizar que los acuerdos de nivel de servicio y los requisitos de baja latencia para cargas de trabajo de visión artificial en tiempo casi real se cumplan de manera rentable mediante el uso de Amazon Elastic Kubernetes Service (Amazon EKS), Amazon Managed Streaming for Apache Kafka (Amazon MSK), y Amazon FSx for Lustre.
Cuando se implementó y probó en la canalización de inferencia de visión por computadora de Sportradar, la latencia para generar una inferencia a partir del modelo de predicción de objetivos presentado en este artículo fue de alrededor de 200 milisegundos, con una latencia total de procesamiento de un extremo a otro de alrededor de 700 milisegundos.
Categoría:Sportsbook
Tags: Sin tags
País: Estados Unidos

Evento
Cristina Turbatu destaca la tecnología en el nuevo Hall 7 de ICE Barcelona
Martes 20 de Oct 2026 / 12:00
CGA destaca la ventaja competitiva de Canadá en ICE Barcelona
Martes 13 de Oct 2026 / 12:00
World Nineball Tour 2027: La Alianza de WorldGaming en ICE Barcelona
Martes 06 de Oct 2026 / 12:00
SUSCRIBIRSE
Para suscribirse a nuestro newsletter, complete sus datos
Reciba todo el contenido más reciente en su correo electrónico varias veces al mes.